
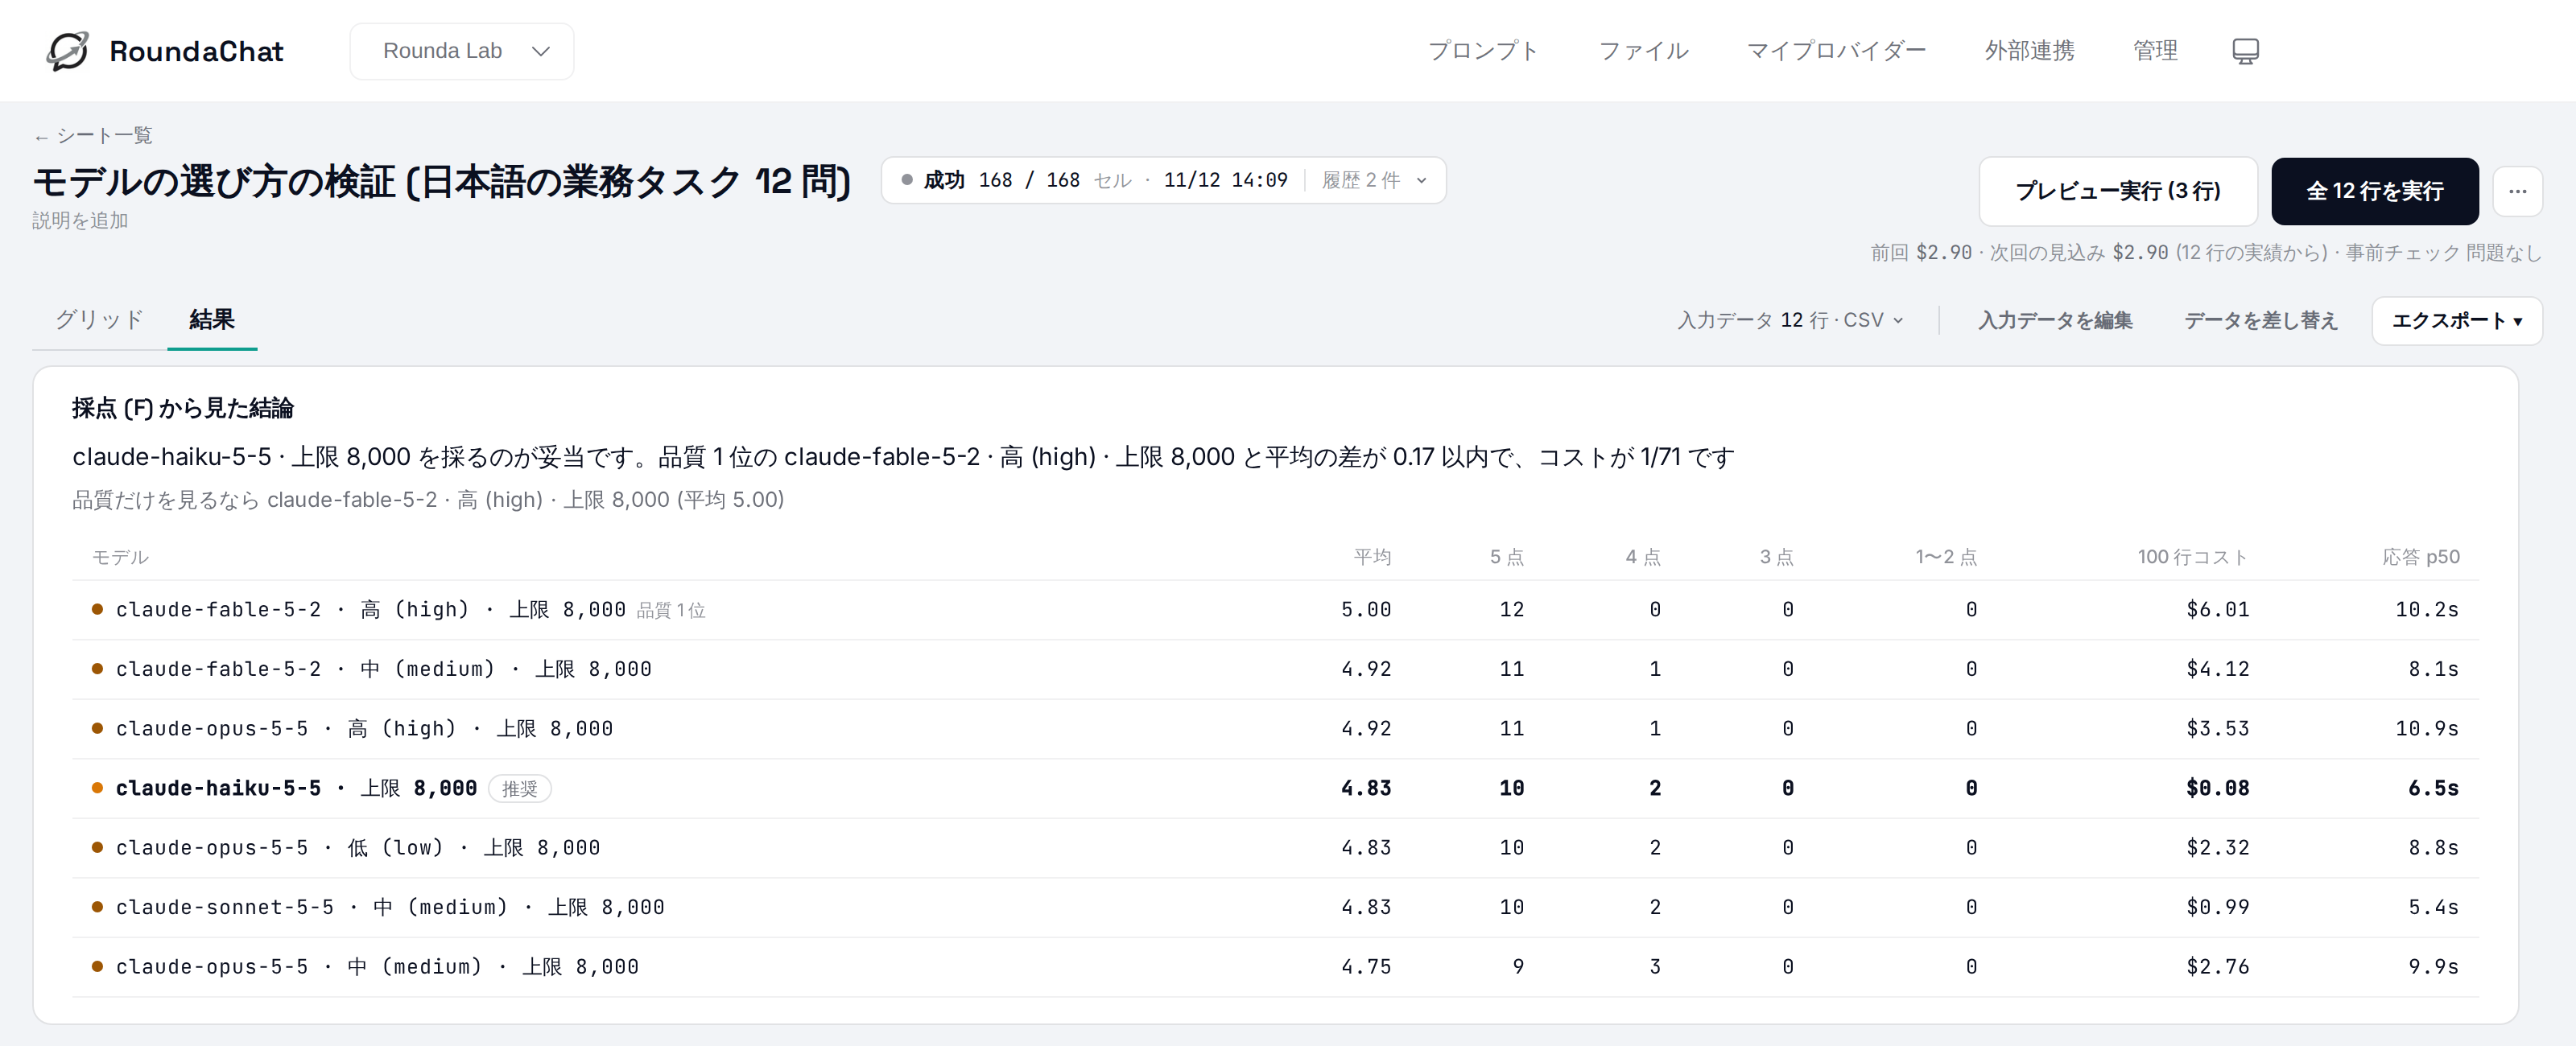
 公式は「まず Opus 5.5」と言う。日本語の業務タスク 24 問で測ったら、点差は出ず費用だけ 63 倍違った
技術ブログ
データ基盤と生成AIの実務で得た知見を、Rounda のメンバーが書いています。
公式は「まず Opus 5.5」と言う。日本語の業務タスク 24 問で測ったら、点差は出ず費用だけ 63 倍違った  コーディングエージェントを用いた開発(2026下期ver)
 Databricks Genieを60回検証して、定義層を見直してみた
 ローカルモデルのqwen3.8:27bをnothinkでバッチ推定する
 Kimi K3とFable5を比較|日本語精度・コストをRoundaChatで検証
 LPのSEO/AEO対策&編集をAIで自動化してみた
 フロンティアモデルをプロンプトのみで比較(GPT-5.5, opus-4.8, 3.5-Flash)
 生成AIで中身とデザイン性のある提案スライドを作る
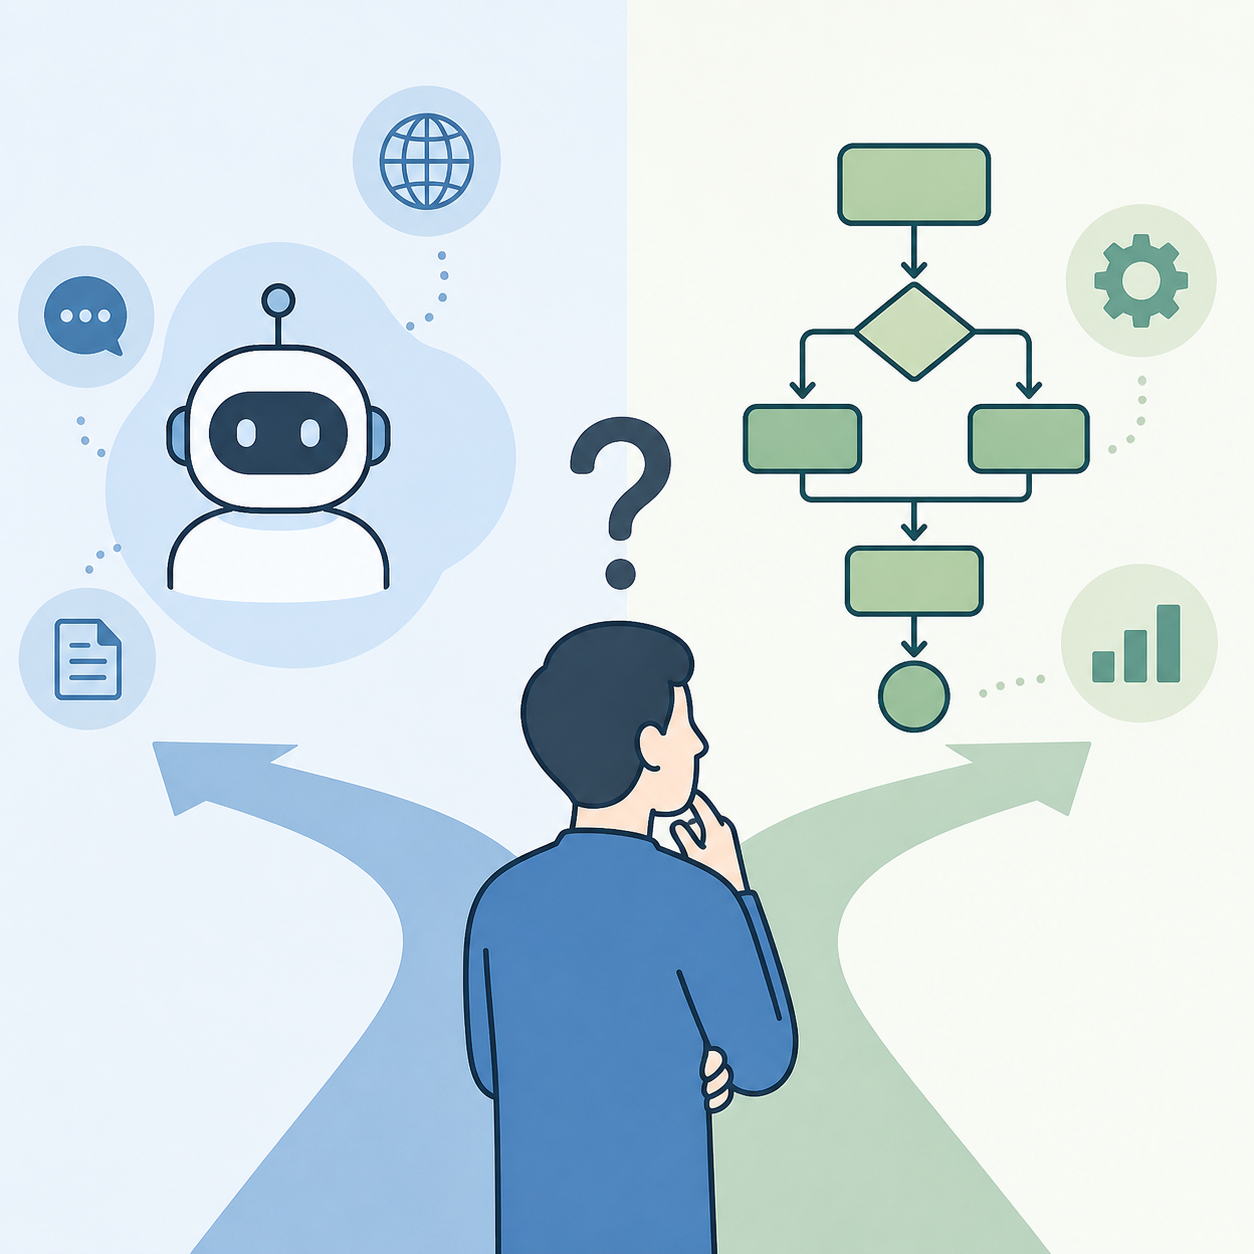 汎用AIエージェントを使うべきか、自前実装すべきか 〜 その判定軸とLangGraphによる特化型エージェントの設計事例〜
 自社ホストしたClickHouseでLooker Studioに描画する
 2025年時点の「データ基盤×LLM」のサービス比較と考察(Snowflake x Databricks x Google)
 Few-Shotプロンプトの「順序」を変えるだけで精度は上がるのか?