
公式は「まず Opus 5.5」と言う。日本語の業務タスク 24 問で測ったら、点差は出ず費用だけ 63 倍違った
 X
 はてな
目次
Anthropic が 11 月 9 日に「Which Claude model should you build with?」という記事を出しました。
Fable 5.2・Opus 5.5・Sonnet 5.5・Haiku 5.5 の選び方をまとめたもので、要点は次の 4 つです。
- ほとんどの仕事は Opus 5.5 の思考の深さ (effort)
mediumから始める - モデルを替える前に、まず effort を調整する
- トークン単価が高くても、タスクあたりの費用が高いとは限らない
- 分類・振り分け・抽出は Haiku 5.5、範囲の決まった日常業務は Sonnet 5.5、最も難しい技術的な仕事は Fable 5.2
記事は測り方も勧めています。実際のタスクを集め、成否のチェックを付け、候補のモデルを 2〜3 の effort で走らせ、費用を記録して比べる、というものです。
公式のベンチマークはコーディングが中心です。そこで、日本語の事務・専門文書のタスクで同じ測り方をしてみました。
先に結論を書きます。
- 24 問・180 点満点で、7 つの設定の点は 173〜179 点に収まりました。 Opus 5.5 と Fable 5.2 の間に、点で示せる差はありませんでした
- 費用は最大で 63 倍違いました。 24 問の生成の費用は、Haiku 5.5 が $0.035、Fable 5.2 (high) が $2.18 です
- effort を上げても点は上がりませんでした。 Opus 5.5 は low から high で費用が 1.44 倍になり、点は 178 → 179 です
- 「単価 2 倍 = 費用 2 倍」ではありませんでした。 同じ medium で、Fable 5.2 の費用は Opus 5.5 の 1.62 倍でした
- AI に採点させると、採点のほうが間違えることがありました。 機械的な検算と人の目が要ります
測ったのは 1 回ずつで、問題も採点基準も私たちが作ったものです。ベンチマークではなく、「自分の業務で測るとこうなった」という一例として読んでください。
測り方
比べた設定
モデル | 思考の深さ | 単価 (入力 / 出力、100 万トークン) |
|---|---|---|
Haiku 5.5 | 既定 | $0.10 / $0.50 |
Sonnet 5.5 | medium | $2 / $10 |
Opus 5.5 | low / medium / high | $4 / $20 |
Fable 5.2 | medium / high | $8 / $40 |
問題
3 ラウンド、合計 24 問です。すべて日本語で、正解か採点の項目を先に決めてから流しました。
ラウンド | 中身 | 配点 |
|---|---|---|
第 1 (12 問) | 公式の 4 区分に 3 問ずつ。問い合わせの分類、請求書の項目の抽出、議事録の要約、クレームへの返信、社内規程への回答、契約条項のリスクの指摘、売上表の分析、2 資料の突合、シフトの割り当て、SQL のバグ、矛盾した依頼の要件整理 など | 各 5 点 |
第 2 (8 問) | 第 1 ラウンドで差が出なかったので難しくしたもの。3 回分の議事録をまたぐ決定の整理、為替と割引つきの見積もり計算、13 条件のシフト、3 つの社内規程をまたぐ判断、入出庫の記録 38 行からの在庫差異の特定、Python のバグ 3 つ、10 条件を同時に満たす書き換え、集計の読み違いの指摘 | 各 5 点 |
第 3 (4 問) | 資料を渡して専門文書を書かせるもの。顧客向けの障害報告書、情報セキュリティ審査への回答書、事業計画書の収支計画の章、RFP への提案書 | 各 20 項目 |
第 2・第 3 ラウンドは、前のラウンドの結果を見てから足しました。差が出る課題を探しにいった、という経緯です。
それでも差が出なかった、というのが今回の結果です。
採点
- 採点基準は「正解と一致するか」「埋めた問題点を指摘したか」のようなチェック項目にしました。文章のうまさでは点を付けません
- 採点も Claude に行わせました (第 1・第 2 ラウンドは Sonnet 5.5、第 3 ラウンドは Opus 5.5)。比べられる側のモデルが採点する弱点があります
- そこで、シフトの割り当てと書式の条件の 2 問はスクリプトでも検算し、減点されたセルは全部、人が出力を読んで確かめました
道具
実行には、私たちが開発している RoundaChat のバッチシートを使いました。問題と採点基準の CSV を読み込み、回答の列に 7 つの設定を並べ、採点の列を足して実行するだけです。
セルごとの費用と時間が記録されます。
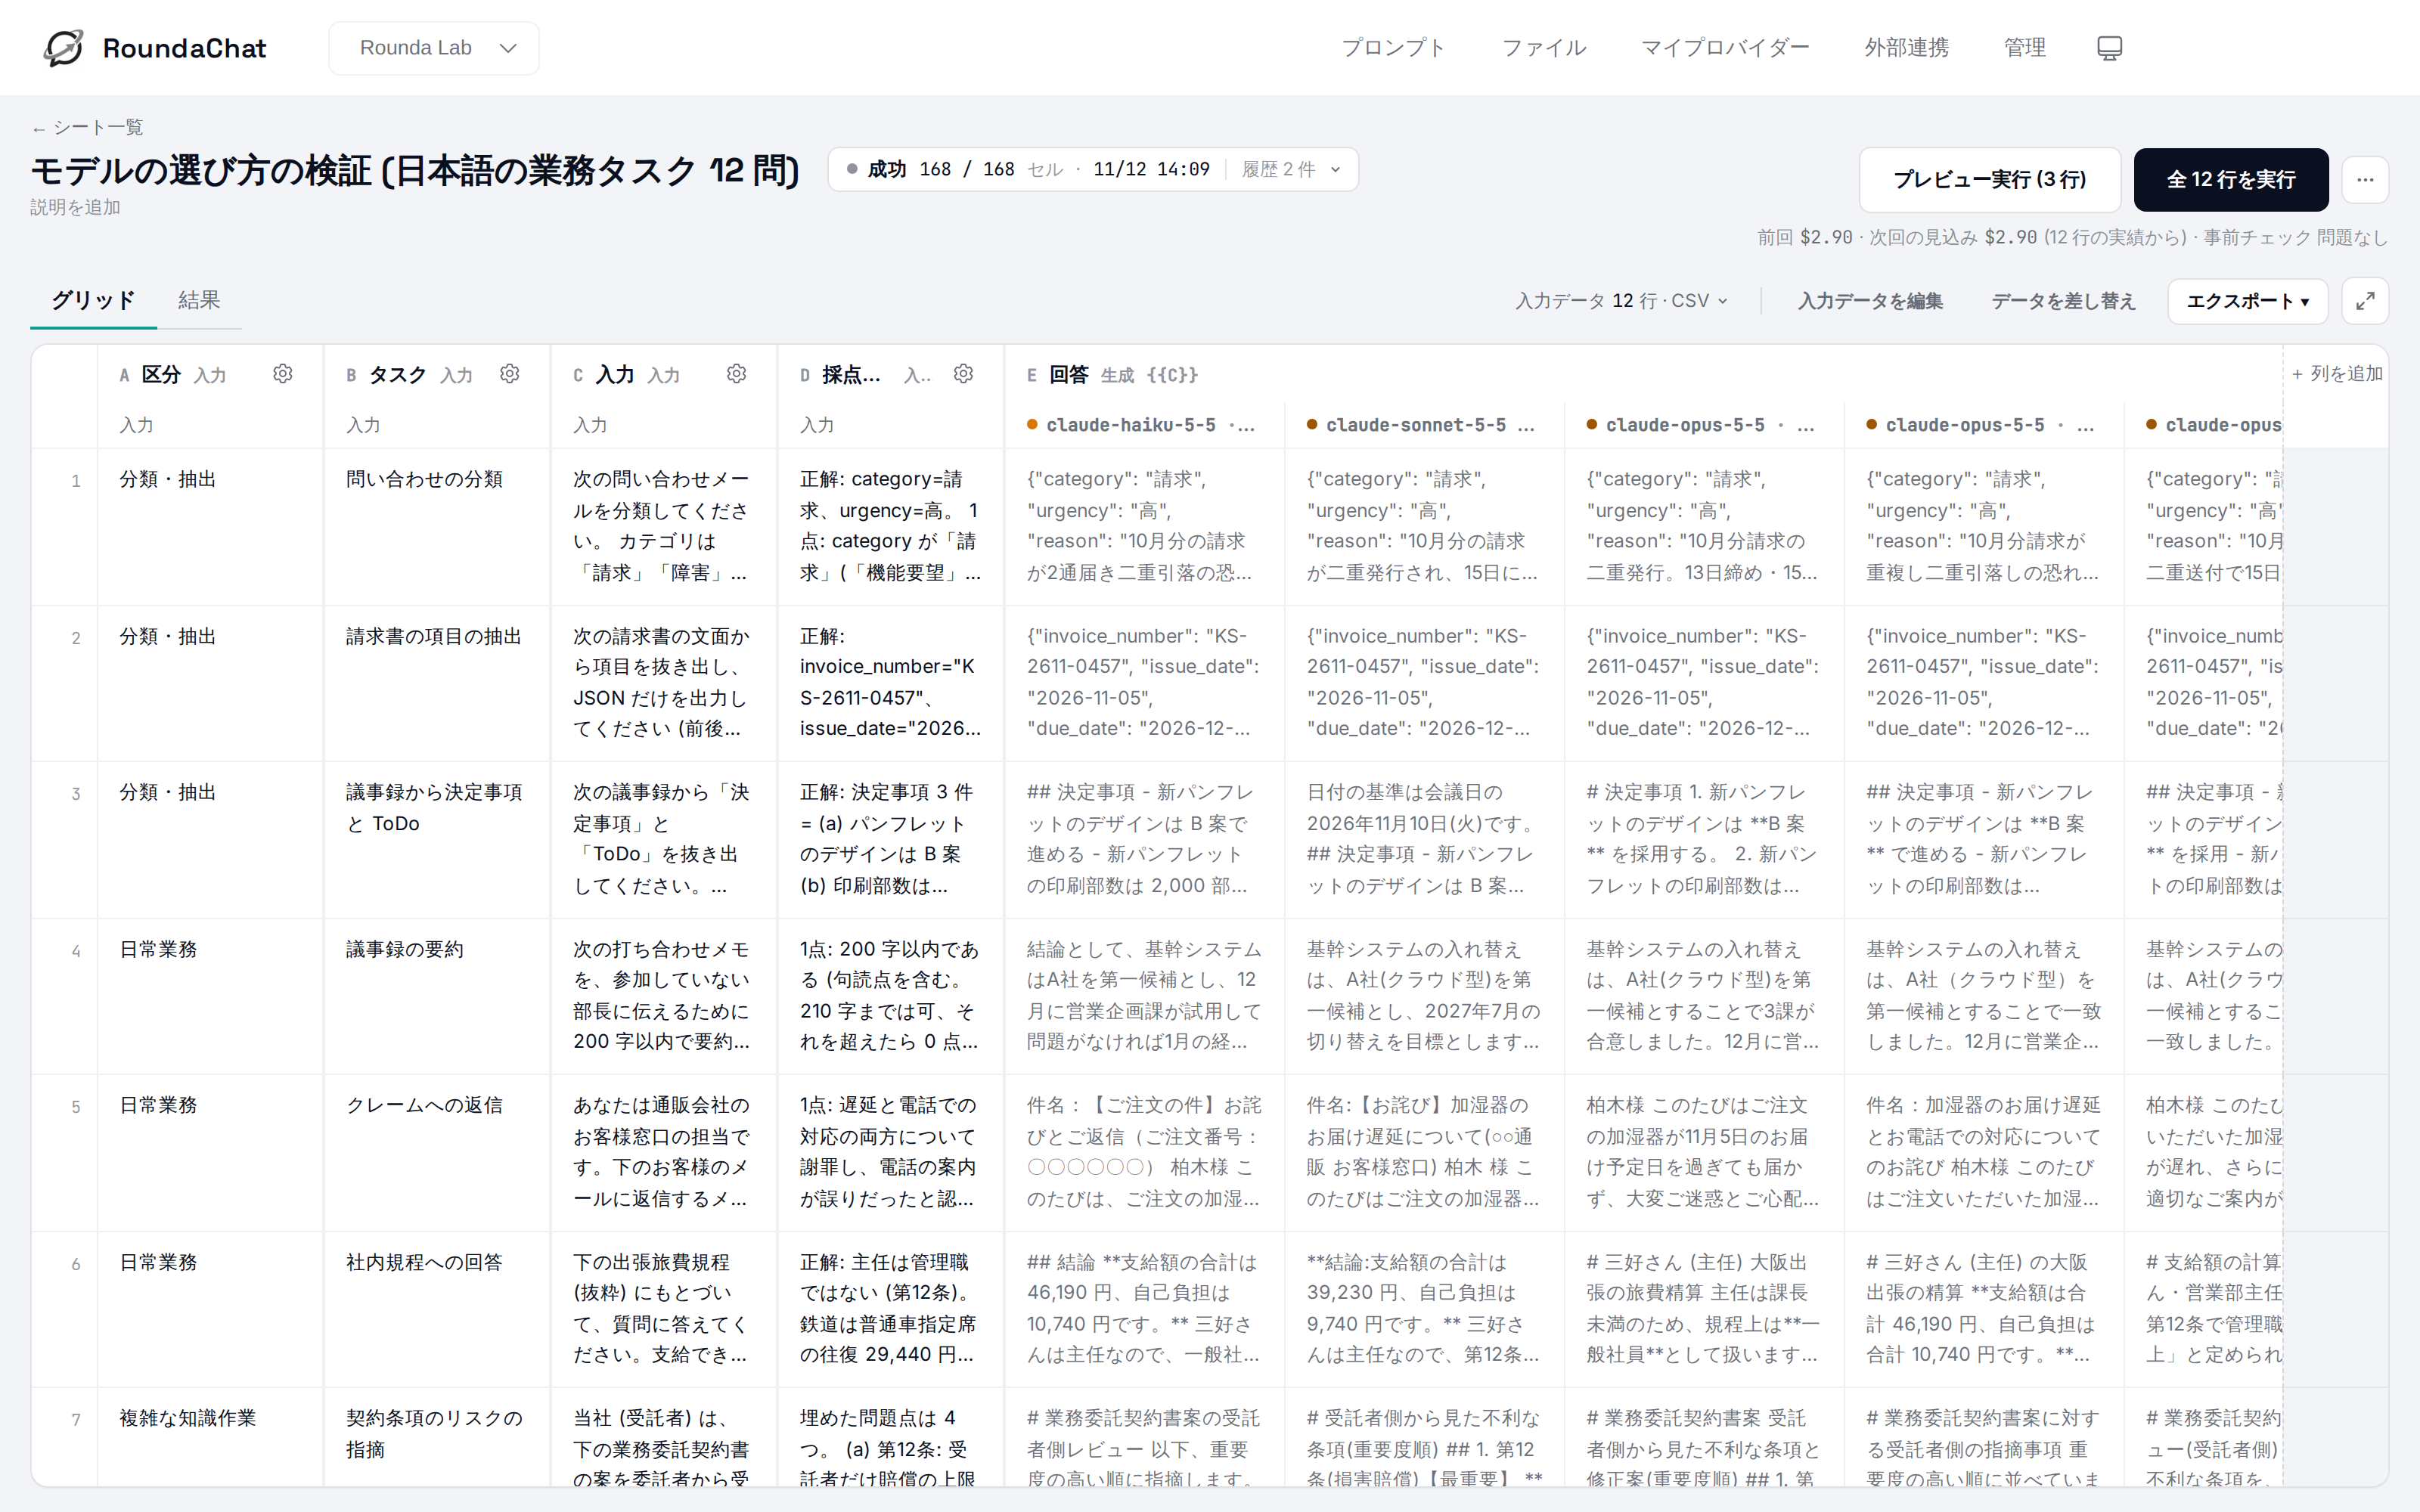
同じモデルを思考の深さだけ変えて並べられるので、「モデルを上げるか、effort を上げるか」をそのまま 1 画面で比べられます。
結果
点はほぼ横並び
設定 | 第 1 (60) | 第 2 (40) | 第 3 (80) | 合計 (180) |
|---|---|---|---|---|
Haiku 5.5 | 58 | 40 | 75 | 173 |
Sonnet 5.5 medium | 58 | 39 | 79 | 176 |
Opus 5.5 low | 58 | 40 | 80 | 178 |
Opus 5.5 medium | 57 | 39 | 80 | 176 |
Opus 5.5 high | 59 | 40 | 80 | 179 |
Fable 5.2 medium | 59 | 40 | 79 | 178 |
Fable 5.2 high | 60 | 34 | 80 | 174 |
24 問のうち 13 問は、7 つの設定すべてが満点でした。「難所」として作った 13 条件のシフト、3 つの規程をまたぐ可否判断、在庫差異の特定、Python のバグ 3 つも、最安の Haiku 5.5 を含めて全員が正解しています。
Fable 5.2 (high) の第 2 ラウンドの 34 点は、1 問で本文が空の回答が返ったためです (0 点)。同じ問題を流し直すと満点だったので、再現しない 1 回きりの事象でした。
原因は分かっていません。
費用は 63 倍
24 問の生成にかかった費用です (採点の費用は含みません)。
設定 | 費用 | Haiku 比 | 出力トークン |
|---|---|---|---|
Haiku 5.5 | $0.035 | 1 倍 | 65,339 |
Sonnet 5.5 medium | $0.333 | 10 倍 | 29,718 |
Opus 5.5 low | $0.814 | 24 倍 | 37,136 |
Opus 5.5 medium | $0.969 | 28 倍 | 44,880 |
Opus 5.5 high | $1.169 | 34 倍 | 54,865 |
Fable 5.2 medium | $1.569 | 46 倍 | 35,649 |
Fable 5.2 high | $2.178 | 63 倍 | 50,858 |
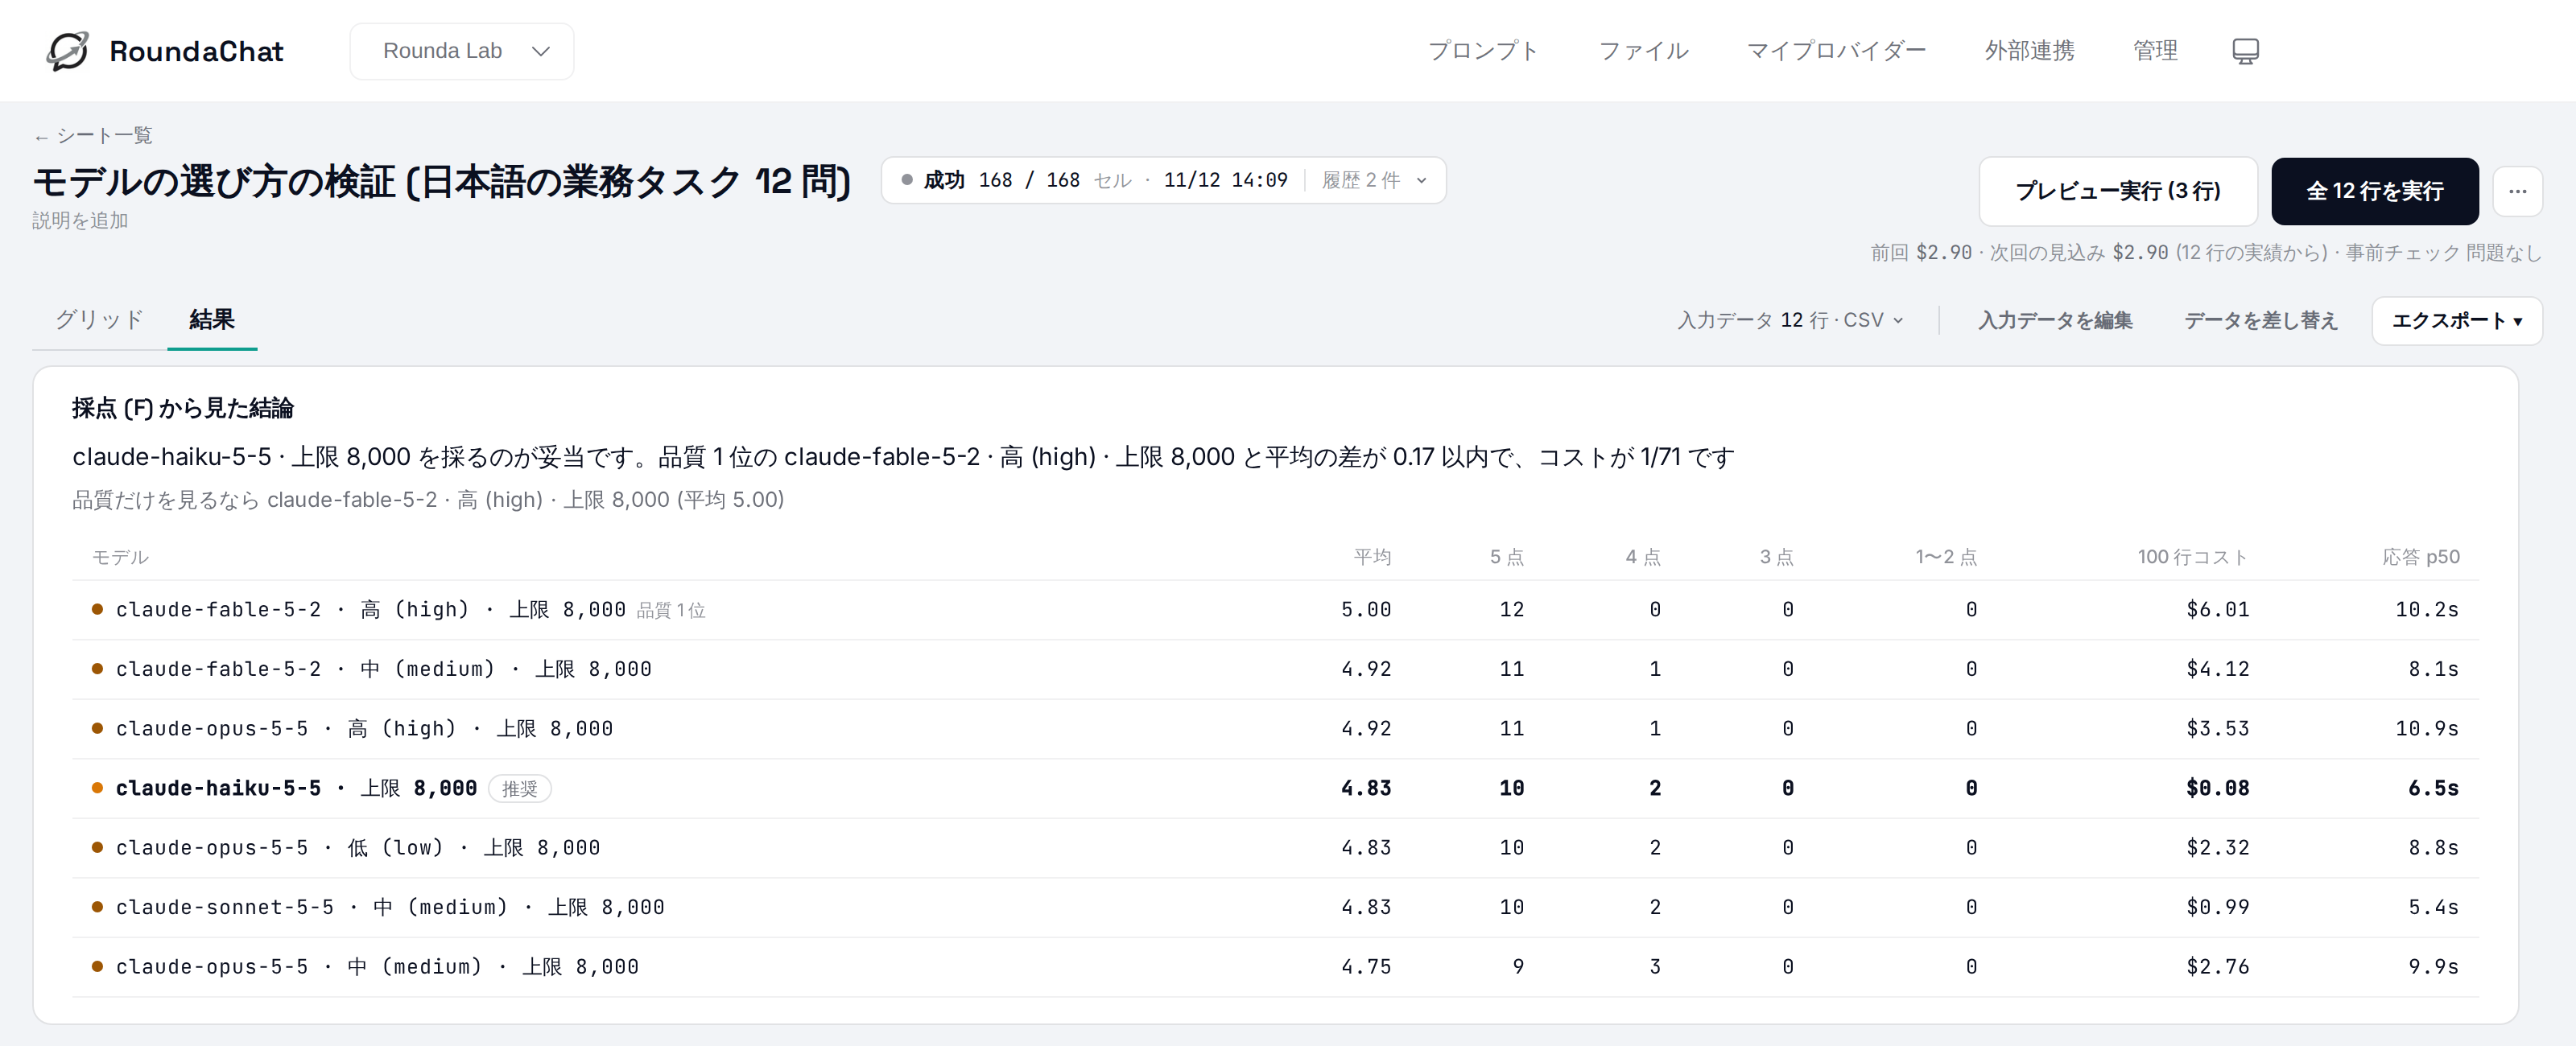
RoundaChat の結果タブは、採点の平均と費用からこう結論を出しました。
(画面は第 1 ラウンドのもので、1/71 は第 1 ラウンドだけの比です)
出力例(RoundaChatからダウンロードしたそのままのもの)
https://docs.google.com/spreadsheets/d/1h7PfMzhaaxg7Dwd3jHO9TWDW4pEMdZ1NBQaJGbUhqGU/edit?usp=sharing
https://docs.google.com/spreadsheets/d/1bWsYxMrX_VOyZmG3aZzjuwZcFNyTIzCkkqL4epA9qIo/edit?usp=sharing
公式の 4 つの主張に答える
1.「まず Opus 5.5 の medium から」→ 今回の範囲では過剰だった
Opus 5.5 (medium) は 176 点、Haiku 5.5 は 173 点、費用は 28 倍です。日本語の事務系のタスクなら、まず Haiku か Sonnet で試し、足りないところだけ上げるほうが理にかなっていました。
ただし、公式が Opus を勧める主な理由は、長いコーディングや複数の手順をまたぐ自律的な作業です。そこは今回測っていません。
2.「モデルを替える前に effort を調整する」→ 上げても点は変わらなかった
Opus 5.5 の low / medium / high は 178 / 176 / 179 点、費用は 1 倍 / 1.19 倍 / 1.44 倍でした。今回のタスクでは、effort を上げて得られたものは費用と待ち時間の増加だけです。
逆に言えば、公式の言うとおり「まず effort を下げてみる」は有効でした。
3.「単価が高くても、タスクあたりの費用が高いとは限らない」→ そのとおりだった
Fable 5.2 の単価は Opus 5.5 の 2 倍ですが、同じ medium での費用は 1.62 倍でした。Fable 5.2 のほうが出力トークンが 2 割少なかったためです (35,649 対 44,880)。
もう 1 つ、意外だったのは Haiku 5.5 です。出力トークンは 7 つの設定で最も多く、Sonnet 5.5 の 2.2 倍でした。
単価が 20 分の 1 なので費用は最安のままですが、応答の時間は最速ではありません。第 3 ラウンドの平均は Haiku 5.5 が 20.8 秒、Sonnet 5.5 が 14.0 秒でした。
4.「分類・抽出は Haiku 5.5」→ そのとおり。ただし専門文書では取りこぼしがあった
分類・抽出の 3 問は全員が満点で、Haiku 5.5 で十分でした。
一方、第 3 ラウンドの専門文書では、Haiku 5.5 だけが 80 点中 5 点を落としました。
- セキュリティ審査の回答書で、対応済みの項目を「一部対応」と書いた
- 提案書で、資料に無い追加費用の可能性を書き足した
- 収支計画で、指定した万円単位の数字を整数に丸めた (1,882.8 万円を 1,883 万円)
どれも「読めば直せる」程度ですが、社外に出す文書では直す手間がかかる種類の誤りです。Opus 5.5 は 3 つの effort のすべてで 80 点満点でした。
点に出なかった差
チェック項目の採点では拾えない差もありました。集計の読み違いを指摘させる問題 (全体では成約率が下がったのに、法人・個人のどちらの層でも上がっている) で、全モデルが正しく指摘しました。
その中で Fable 5.2 (high) は、25 ポイントの低下を「構成の変化で −30、フォームの効果で +5」に分解し、各層の差が統計的に有意とは言えないことまで踏み込んでいました。
採点基準に無い深さなので点は同じです。「正しいかどうか」を超えて「どこまで考えてほしいか」が要る仕事では、上位のモデルを選ぶ理由になります。
AI の採点は、採点のほうが間違える
今回いちばん手間がかかったのは採点の確認でした。
- 採点基準の書き方で 6 つの設定が不当に減点されました。 契約条項のレビューで「問題の無い条項を重大として挙げない」という項目を作ったところ、「軽微」と断って挙げた回答まで減点されました。埋めた 4 つの問題点は全員が指摘しています
- 採点者が自分で「正しい」と書きながら減点した例が 2 件ありました。 理由の文を読むと、誤りを探して見つからなかった経過がそのまま書かれ、それでも × になっていました
- 機械で検算できる問題では、AI の採点と一致しました。 シフトの 13 条件と書式の 10 条件は、スクリプトの検算と AI の採点が 14 セルすべてで同じ結果でした。350 字以内の条件に対して 358 字だった 1 件も、AI の採点が拾っています
AI の採点は、項目が具体的で正解がはっきりしていれば当てになります。判断の入る項目では、理由の文を人が読む前提で使うのがよさそうです。
この検証の限界
- 各設定 1 回ずつの実行です。繰り返していないので、1〜2 点の差に意味はありません
- 問題と採点基準は私たちが作りました (作成に Claude も使っています)。件数も 24 問です
- 採点者も Claude です
- 測っていない範囲: 長時間の自律的な作業、大きなコードベース、数万字を超える入力、画像や PDF の読み取り。公式が Opus 5.5 や Fable 5.2 を勧めるのは主にこの範囲です
- かかった費用は、採点と試し実行を含めて合計 $9.42 でした
まとめ: 自分のタスクで測る
公式の記事のいちばん大事な部分は、モデルの序列ではなく「自分のタスクで測れ」という勧めだと思います。今回の 24 問では、点の差は出ず、費用の差だけがはっきり出ました。
別の業務では違う結果になるはずです。
測るのに要ったのは、問題と採点基準を書いた CSV 1 枚でした。RoundaChat は、チームで生成 AI の使い方を比べ、蓄積するためのサービスで、現在クローズドβの参加企業を募集しています。
自社の業務で同じ比較を試したい方は、β のご案内 をご覧ください。
関連記事


データ基盤や生成AIの活用でお困りのことがあれば
課題の整理だけでも構いません。30 分の無料相談で、いまの状況に合う進め方をご提案します。